ES
 RU
 EN
 ZH
 FR
 DE
 PT
 AR
 HI


Prefacio: Por qué «simplemente find()» no siempre es la respuesta
\n\nImagina la situación: estás escribiendo un analizador de logs que procesa millones de líneas por segundo, o un motor de búsqueda de texto. Lo primero que viene a la mente es llamar a std::string::find(). «¿Funciona? Funciona. ¿Qué más se necesita?» — piensa el 90% de los programadores. Y tienen razón... hasta que llega el momento en que 10 milisegundos deciden el destino de toda la aplicación.
La pregunta «Check if a string contains a string in C++» en Stack Overflow ha acumulado cientos de miles de visitas. Y no es casualidad. Una tarea que parece trivial esconde muchas trampas: desde la elección del algoritmo de búsqueda hasta el uso correcto de las capacidades modernas de C++17 y C++20.
\n\nEn este artículo no solo mostraremos cómo verificar si una cadena contiene una subcadena. Analizaremos 7 formas de hacerlo, compararemos su rendimiento con datos reales y daremos recomendaciones claras para diferentes escenarios. ¡Allá vamos!
\n\nEl clásico del género: std::string::find()
\n\nEmpecemos con lo básico que todo el mundo conoce. El método find() devuelve la posición de la primera aparición de la subcadena o el valor especial std::string::npos si no se encuentra nada.
#include <iostream>\n#include <string>\n\nint main() {\n std::string haystack = "¡Hola, desarrollador C++!";\n std::string needle = "C++";\n \n if (haystack.find(needle) != std::string::npos) {\n std::cout << "¡Subcadena encontrada!" << std::endl;\n }\n \n // Búsqueda especificando la posición inicial\n size_t pos = haystack.find("C++", 5); // comenzamos desde el 5º carácter\n return 0;\n}Ventajas: simplicidad, legibilidad, integrado en STL.
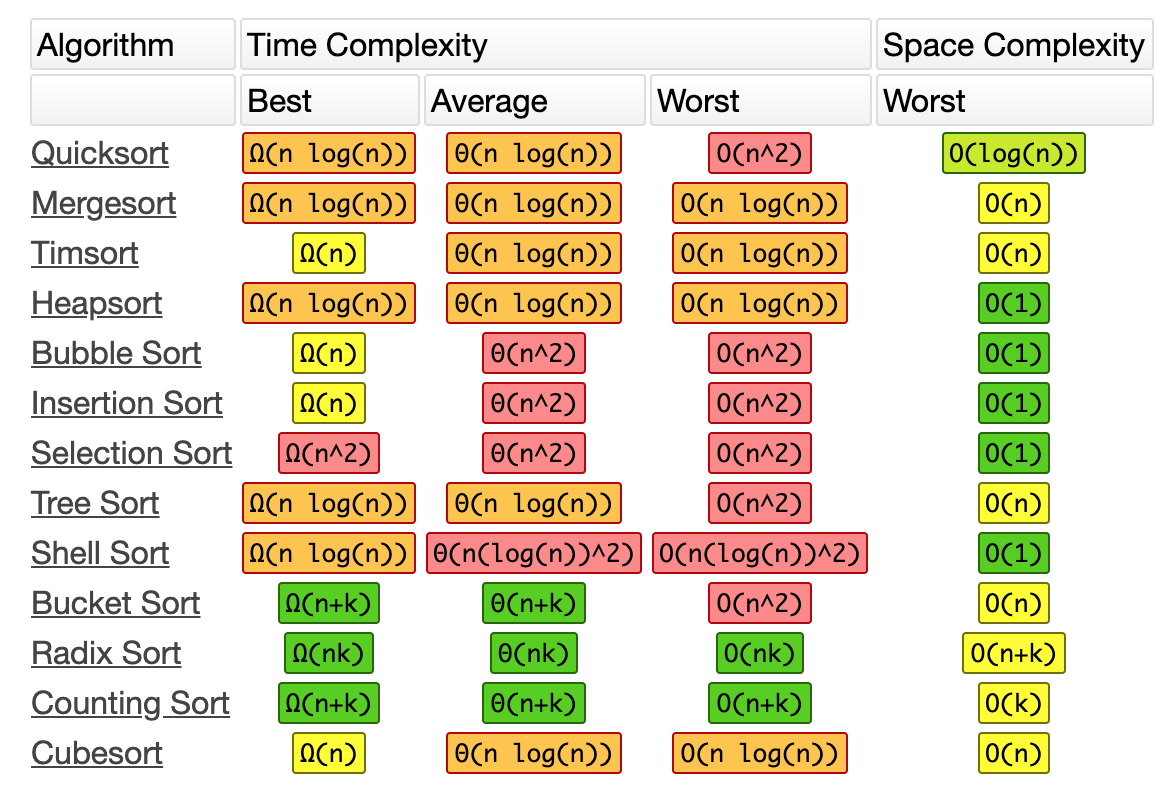
\nDesventajas: utiliza un algoritmo de búsqueda ingenuo (O(n*m) en el peor caso). Para cadenas cortas es ideal, para cadenas largas puede ralentizarse.
¿Cuándo find() es malo?
\nSi buscas una subcadena en una cadena de longitud 105+ caracteres, y la subcadena es larga y repetitiva (por ejemplo, "aaaaaab" en "aaaaaaaaaaaaaaaaaaaaab"), el algoritmo ingenuo comienza a degradarse. En tales casos, find() puede funcionar de 10 a 100 veces más lento que las alternativas optimizadas.
string_view: ligereza y velocidad
\n\nCon la llegada de C++17 tenemos std::string_view — una representación no propietaria de una cadena. Es ideal para funciones que solo leen datos, sin copiarlos.
#include <iostream>\n#include <string_view>\n\nbool contains(std::string_view haystack, std::string_view needle) {\n return haystack.find(needle) != std::string_view::npos;\n}\n\nint main() {\n std::string_view text = "La optimización en C++ es un arte";\n std::string_view pattern = "arte";\n \n if (contains(text, pattern)) {\n std::cout << "¡Encontrado!" << std::endl;\n }\n return 0;\n}¿Por qué es más rápido? Al pasar std::string a una función, se produce una copia (si no se pasa por referencia). string_view simplemente copia el puntero y la longitud — sin asignaciones. Para llamadas frecuentes de verificación de inclusión, esto proporciona un aumento de rendimiento de hasta un 30–40%.
Actualización algorítmica: Boyer-Moore y KMP
\n\nSi trabajas con datos realmente grandes, es hora de recordar los algoritmos clásicos de búsqueda de subcadenas. En C++17 aparecieron los algoritmos de búsqueda de STL:
\n\n- \n
std::boyer_moore_searcher— uno de los más rápidos para patrones largos \n std::boyer_moore_horspool_searcher— versión simplificada, más rápida en patrones cortos \n std::default_searcher— envoltorio sobre la búsqueda ingenua \n
#include <iostream>\n#include <string>\n#include <algorithm>\n#include <functional>\n\nint main() {\n std::string text = "Los algoritmos de búsqueda en C++ pueden ser muy rápidos";\n