RU
 EN
 ES
 ZH
 FR
 DE
 PT
 AR
 HI


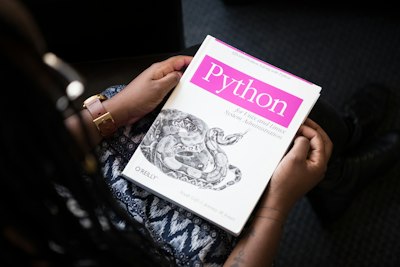
Обработка естественного языка на Python
Практическое введение в NLP с NLTK
Краткое содержимое:
Введение
Книга «Natural Language Processing with Python» (в русском переводе — «Обработка естественного языка на Python») авторства Стивена Бёрда, Юэна Кляйна и Эдварда Лопера — это классическое руководство по практическому применению методов компьютерной лингвистики с использованием языка Python. Вышедшая в 2009 году, она до сих пор остаётся одним из лучших введений в тему для начинающих и intermediate-разработчиков. Книга построена вокруг библиотеки NLTK (Natural Language Toolkit), которая стала стандартом де-факто для образовательных и исследовательских проектов в области NLP.
О чём эта книга
Книга последовательно проводит читателя от базовых операций с текстом до сложных задач синтаксического и семантического анализа. Основное внимание уделяется практическим примерам и работе с реальными корпусами текстов. Авторы не просто перечисляют функции библиотеки, а объясняют лингвистические и алгоритмические принципы, стоящие за каждым инструментом.
Основные темы, освещаемые в книге:
- Токенизация и работа со строками — разбиение текста на слова и предложения, регулярные выражения.
- Частеречная разметка (POS-tagging) — автоматическое определение грамматических категорий слов.
- Стемминг и лемматизация — приведение слов к нормальной форме.
- Классификация текстов — обучение моделей для определения тональности, тематики и других меток.
- Извлечение информации — поиск именованных сущностей, отношений между ними.
- Синтаксический анализ (parsing) — построение деревьев зависимостей и составляющих.
- Семантика и логический вывод — представление смысла предложений в формальной логике.
- Работа с корпусами — загрузка, анализ и визуализация данных из встроенных коллекций NLTK.
Для кого эта книга
Книга ориентирована на программистов, уже знакомых с основами Python, но не имеющих глубоких знаний в лингвистике или машинном обучении. Она идеально подходит для:
- Студентов технических специальностей, изучающих обработку текстов.
- Data Scientist’ов, которые хотят добавить NLP в свой арсенал.
- Лингвистов, желающих автоматизировать анализ языковых данных.
- Разработчиков, создающих чат-ботов, анализаторы отзывов или поисковые системы.
Что узнает читатель
После прочтения книги вы сможете:
- Уверенно работать с библиотекой NLTK и её корпусами.
- Писать скрипты для автоматической обработки больших объёмов текста.
- Строить классификаторы для определения тональности, авторства или тематики.
- Извлекать из текста структурированную информацию (даты, имена, места).
- Понимать принципы работы синтаксических анализаторов и семантических моделей.
- Применять методы машинного обучения (наивный Байес, максимальная энтропия) к текстовым данным.
Сильные стороны
Главное достоинство книги — её практическая направленность. Каждая глава содержит множество примеров кода, которые можно сразу запустить и модифицировать. Авторы используют реальные тексты (книги, новости, диалоги), что делает обучение наглядным. Кроме того, книга написана живым, доступным языком, а сложные концепции объясняются через простые аналогии.
Отдельно стоит отметить глубину материала: несмотря на вводный характер, книга затрагивает такие продвинутые темы, как контекстно-свободные грамматики, логический вывод и работа с семантическими сетями. Это позволяет читателю не только научиться пользоваться инструментами, но и понять, как они устроены «под капотом».
Также книга полностью бесплатна в электронном виде (доступна на сайте NLTK), что делает её доступной для всех желающих.
Кому рекомендуется
Я рекомендую эту книгу всем, кто делает первые шаги в обработке естественного языка. Она станет отличным стартом перед изучением более современных библиотек (spaCy, transformers) и глубокого обучения. Если вы хотите понять фундаментальные принципы NLP и научиться решать практические задачи с помощью Python — эта книга для вас.
Однако стоит учитывать, что книга была написана в 2009 году, и некоторые примеры могут использовать устаревшие версии библиотек. Тем не менее, основные концепции остаются актуальными, а код легко адаптируется под современные версии Python и NLTK.